چطور Bottleneck شبکه را شناسایی کنیم؟ راهنمای تخصصی تشخیص گلوگاههای عملکردی در شبکههای سازمانی
کندی شبکه یکی از رایجترین چالشهای زیرساخت فناوری اطلاعات در سازمانها است. بسیاری از مدیران شبکه زمانی متوجه وجود مشکل میشوند که کاربران از کندی نرمافزارها، اختلال در تماسهای VoIP، تأخیر در دسترسی به فایلها یا افت کیفیت سرویسهای ابری شکایت میکنند. اما واقعیت این است که «کندی شبکه» یک مشکل مستقل نیست؛ بلکه نشانهای از وجود یک Bottleneck شبکه یا گلوگاه در بخشی از زیرساخت است.
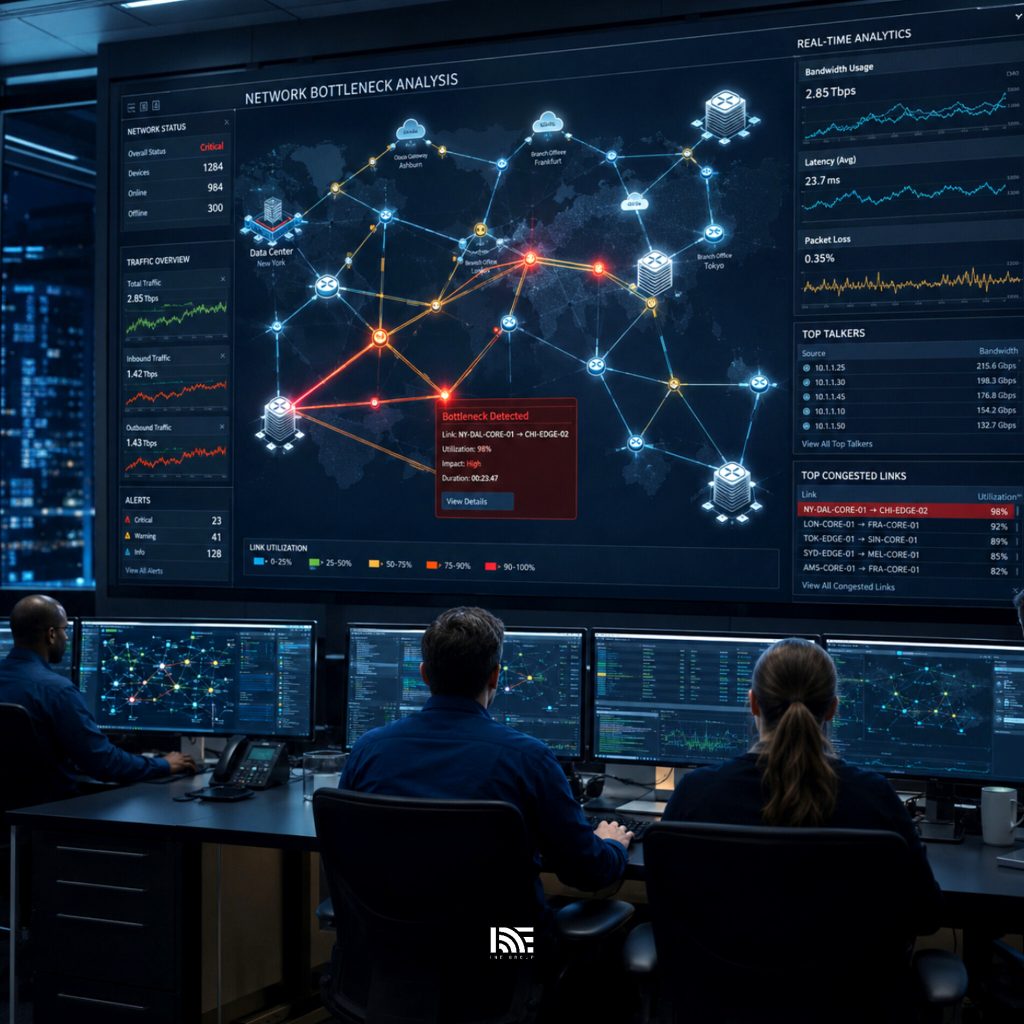
گلوگاه شبکه به نقطهای گفته میشود که ظرفیت پردازش، انتقال یا ذخیرهسازی آن کمتر از میزان تقاضای واقعی باشد. در چنین شرایطی، کل عملکرد شبکه تحت تأثیر ضعیفترین بخش قرار میگیرد. شناسایی دقیق این نقاط، نخستین گام در بهینهسازی عملکرد شبکه و جلوگیری از افت بهرهوری سازمان است.
در شبکههای مدرن که ترکیبی از تجهیزات فیزیکی، سرویسهای ابری، ارتباطات SD-WAN، VPN، VoIP و نرمافزارهای سازمانی هستند، تشخیص گلوگاه بهمراتب پیچیدهتر از گذشته شده است و نیازمند رویکردی مبتنی بر مانیتورینگ، تحلیل داده و مشاهدهپذیری یا Observability است.
Bottleneck شبکه چیست؟
Bottleneck به هر نقطهای از مسیر ارتباطی گفته میشود که محدودیت آن باعث کاهش سرعت انتقال داده، افت Throughput یا افزایش تأخیر در سرویسها شود.
این محدودیت میتواند در بخشهای مختلفی از زیرساخت ایجاد شود، از جمله:
- لینکهای ارتباطی WAN و اینترنت
- سوئیچها و روترها
- فایروالها
- تجهیزات وایرلس
- سرورها
- ذخیرهسازها مانند SAN و NAS
- ماشینهای مجازی
- نرمافزارهای سازمانی
- سرویسهای ابری
یکی از اشتباهات رایج در سازمانها این است که هرگونه کاهش عملکرد را به پهنای باند اینترنت نسبت میدهند، در حالی که در بسیاری از موارد علت اصلی در بخشهای دیگری از زیرساخت قرار دارد. برای مثال ممکن است لینک اینترنت ظرفیت کافی داشته باشد، اما فایروال، سرور، Storage یا حتی یک پورت سوئیچ معیوب باعث افت عملکرد کل سرویس شود.
مهمترین نشانههای وجود Bottleneck در شبکه
پیش از آغاز فرآیند عیبیابی باید علائم هشداردهنده را شناسایی کرد. اگر این نشانهها بهصورت تکرارشونده یا در ساعات مشخصی از روز رخ دهند، احتمال وجود گلوگاه در شبکه یا زیرساخت بسیار بالاست.
از مهمترین نشانههای وجود Bottleneck شبکه میتوان به موارد زیر اشاره کرد:
- افزایش زمان پاسخگویی نرمافزارها
- کندی انتقال فایلها
- قطعی یا افت کیفیت تماسهای VoIP
- افزایش Packet Loss
- افزایش Latency
- افزایش Jitter
- کاهش Throughput
- اشباع شدن لینکهای ارتباطی
- افزایش خطاهای CRC و FCS روی پورتهای سوئیچ
- افزایش مصرف CPU تجهیزات شبکه
- افزایش مصرف حافظه تجهیزات
- نارضایتی کاربران در ساعات اوج مصرف
در بسیاری از سازمانها این علائم ماهها وجود دارند، اما به دلیل نبود سیستم مانیتورینگ مناسب، علت اصلی هرگز شناسایی نمیشود. نتیجه این وضعیت معمولاً تصمیمهای پرهزینه و کماثر مانند افزایش پهنای باند، تعویض تجهیزات یا تغییر سرویسدهنده بدون تحلیل دقیق است.
اولین قدم: ایجاد Baseline عملکرد شبکه
یکی از مهمترین اصول مانیتورینگ مدرن، تعریف Baseline یا الگوی عملکرد عادی شبکه است. بدون داشتن معیار مشخص از وضعیت نرمال، تشخیص رفتار غیرعادی تقریباً غیرممکن خواهد بود.
Baseline باید در بازههای زمانی مختلف مانند ساعات کاری، ساعات اوج مصرف، پایان ماه، زمان اجرای Backup و دورههای پرترافیک ثبت شود. این کار کمک میکند تیم شبکه متوجه شود چه زمانی یک شاخص واقعاً غیرعادی است و چه زمانی بخشی از رفتار طبیعی سازمان محسوب میشود.
Baseline عملکرد شبکه بهتر است شامل شاخصهای زیر باشد:
- میزان مصرف پهنای باند
- میانگین Latency
- نرخ Packet Loss
- مصرف CPU تجهیزات
- مصرف RAM
- حجم ترافیک کاربران
- نرخ خطاهای پورتها
- میزان مصرف Storage و Disk I/O در سرویسهای وابسته
این اطلاعات به تیم شبکه کمک میکند تا به جای تصمیمگیری بر اساس حدس و تجربه پراکنده، تغییرات واقعی را شناسایی کند. برای مثال اگر Latency یک مسیر همیشه حدود 20 میلیثانیه بوده و ناگهان به 120 میلیثانیه رسیده است، میتوان با اطمینان بیشتری وارد فرآیند ریشهیابی شد.
شناسایی گلوگاه در لایه فیزیکی
برخلاف تصور بسیاری از مدیران فناوری اطلاعات، بخش قابل توجهی از مشکلات عملکردی از لایه فیزیکی شبکه ناشی میشود. کابلکشی غیراستاندارد، کانکتور معیوب یا یک پورت ناپایدار میتواند عملکرد یک سرویس حیاتی را بهشدت تحت تأثیر قرار دهد.
در بررسی لایه فیزیکی باید موارد زیر به دقت کنترل شوند:
- کابلهای آسیبدیده یا غیراستاندارد
- کانکتورهای معیوب
- Patch Panelهای فرسوده
- لینکهای ناپایدار
- پورتهای Flapping
- عدم تطابق سرعت و Duplex
- خطاهای CRC یا FCS روی پورتهای سوئیچ
وجود خطاهای CRC یا FCS روی پورتهای سوئیچ معمولاً نشانهای از مشکل در کابلکشی، کانکتور، ماژول نوری یا تجهیزات فیزیکی است و میتواند باعث کاهش شدید کارایی شبکه شود. در پروژههای حرفهای، استفاده از تجهیزات Certifier برای تست و تأیید لینکهای ساختاریافته توصیه میشود.
بررسی تجهیزات شبکه
پس از اطمینان از سلامت لایه فیزیکی، باید وضعیت تجهیزات Active بررسی شود. سوئیچها، روترها، فایروالها، کنترلرهای وایرلس و تجهیزات SD-WAN همگی میتوانند در شرایط خاص به گلوگاه عملکردی تبدیل شوند.
شاخصهای مهم برای بررسی تجهیزات شبکه عبارتاند از:
- CPU Utilization
- Memory Utilization
- Interface Utilization
- Queue Length
- Packet Drops
- Buffer Utilization
- Session Count در فایروالها
- Throughput واقعی نسبت به ظرفیت اسمی دستگاه
اگر مصرف پردازنده روتر یا فایروال بهصورت مداوم بالاتر از 70 تا 80 درصد باشد، احتمال ایجاد گلوگاه بسیار زیاد است. همچنین صفهای طولانی پردازش بستهها میتوانند منجر به افزایش تأخیر و افت کیفیت سرویس شوند.
در بسیاری از سازمانها مشاهده میشود که ارتقای پهنای باند انجام شده، اما فایروال یا روتر قدیمی توان پردازش حجم جدید ترافیک را ندارد. در چنین شرایطی، افزایش ظرفیت لینک نه تنها مشکل را حل نمیکند، بلکه فشار بیشتری به تجهیزی وارد میکند که از قبل در مرز ظرفیت خود کار میکرده است.
تحلیل ترافیک شبکه با NetFlow، sFlow و IPFIX
یکی از مؤثرترین روشهای شناسایی Bottleneck شبکه، تحلیل جریان ترافیک است. فناوریهایی مانند NetFlow، sFlow و IPFIX امکان مشاهده دقیق الگوهای مصرف شبکه را فراهم میکنند.
با استفاده از این ابزارها میتوان مشخص کرد:
- کدام کاربران بیشترین مصرف را دارند.
- کدام نرمافزارها پهنای باند را اشغال کردهاند.
- چه سرویسهایی باعث افزایش بار شبکه شدهاند.
- نقاط اشباع در مسیر ارتباطی کجا قرار دارند.
- چه نوع ترافیکی در ساعات اوج مصرف غالب است.
در بسیاری از موارد مشخص میشود که سرویسهای Backup، انتقال فایلهای حجیم، ترافیک ویدئویی، همگامسازی ابری یا بهروزرسانیهای نرمافزاری عامل اصلی ایجاد گلوگاه هستند. بدون تحلیل جریان ترافیک، این الگوها معمولاً از دید تیم شبکه پنهان میمانند.
بررسی Latency و Packet Loss
دو شاخص کلیدی در تشخیص گلوگاه، Latency و Packet Loss هستند. افزایش Latency معمولاً نشاندهنده وجود ازدحام، تأخیر پردازشی یا مسیر نامناسب در بخشی از ارتباط است.
از سوی دیگر، Packet Loss میتواند ناشی از عوامل مختلفی باشد، از جمله:
- اشباع لینک
- خرابی تجهیزات
- اختلال در ارتباطات WAN
- مشکلات وایرلس
- تنظیمات نادرست QoS
- صفهای پرشده در روتر یا فایروال
پایش مستمر این شاخصها در مسیرهای حیاتی سازمان، دید بسیار ارزشمندی درباره عملکرد واقعی شبکه ارائه میدهد. این موضوع بهویژه برای سرویسهایی مانند VoIP، ویدئوکنفرانس، ERP، CRM، دسکتاپ مجازی و سرویسهای ابری اهمیت زیادی دارد.
نقش QoS در کنترل گلوگاههای شبکه
در برخی موارد گلوگاه به دلیل کمبود مطلق ظرفیت نیست، بلکه به دلیل مدیریت نادرست اولویت ترافیک ایجاد میشود. برای مثال اگر ترافیک Backup یا دانلود فایلهای حجیم با تماسهای VoIP در یک مسیر مشترک رقابت کند، کیفیت تماسها بهسرعت افت میکند.
Quality of Service یا QoS به مدیران شبکه کمک میکند ترافیکهای حساس به تأخیر مانند صوت، ویدئوکنفرانس و اپلیکیشنهای حیاتی را نسبت به ترافیکهای کماهمیتتر اولویتبندی کنند.
البته QoS جایگزین ظرفیت کافی نیست. اگر لینک ارتباطی بهصورت مداوم اشباع باشد، QoS فقط میتواند توزیع منابع را بهتر کند، اما مشکل اصلی ظرفیت همچنان باید با توسعه زیرساخت یا اصلاح الگوی مصرف برطرف شود.
نقش Observability در شبکههای مدرن
در سالهای اخیر رویکرد سنتی مانیتورینگ به سمت Network Observability حرکت کرده است. در این مدل تنها به مشاهده وضعیت تجهیزات اکتفا نمیشود، بلکه دادههای حاصل از Metrics، Logs، Flows، Telemetry و APM بهصورت یکپارچه تحلیل میشوند.
این رویکرد کمک میکند ارتباط میان عملکرد شبکه، وضعیت سرورها و تجربه واقعی کاربران بهتر درک شود. برای مثال ممکن است از دید تجهیزات شبکه همهچیز عادی به نظر برسد، اما دادههای APM نشان دهند که یک سرویس به دلیل تأخیر پایگاه داده یا اشباع Disk I/O کند شده است.
Observability بهویژه در محیطهای Hybrid Cloud، SD-WAN، Kubernetes، سرویسهای SaaS و معماریهای توزیعشده اهمیت بالایی پیدا کرده است. در چنین محیطهایی مسیر ارتباطی کاربران تا سرویس نهایی میتواند از چندین لایه فیزیکی، مجازی و ابری عبور کند.
گلوگاه همیشه در شبکه نیست
یکی از مهمترین نکاتی که مدیران زیرساخت باید در نظر داشته باشند این است که هر مشکل عملکردی الزاماً به شبکه مربوط نمیشود. بسیاری از مشکلاتی که در ظاهر شبیه کندی شبکه هستند، ریشه در سرورها، ذخیرهسازها، پایگاه داده یا نرمافزار دارند.
در بسیاری از موارد عامل اصلی عبارت است از:
- کمبود CPU سرور
- کمبود RAM
- اشباع Storage
- تأخیر Disk I/O
- مشکلات پایگاه داده
- ضعف نرمافزار کاربردی
- تنظیمات نامناسب ماشینهای مجازی
- محدودیت منابع در سرویسهای ابری
به همین دلیل عیبیابی حرفهای باید تمام لایههای زیرساخت را بهصورت همزمان بررسی کند. در غیر این صورت ممکن است زمان و هزینه زیادی صرف ارتقای بخشی شود که اساساً عامل مشکل نیست.
بهترین ابزارهای شناسایی Bottleneck شبکه
برای سازمانهای متوسط و بزرگ، استفاده از ابزارهای مانیتورینگ حرفهای ضروری است. این ابزارها امکان مشاهده بلادرنگ وضعیت تجهیزات، ترافیک شبکه، ظرفیت لینکها و روندهای عملکردی را فراهم میکنند.
برخی از ابزارهای متداول برای شناسایی Bottleneck شبکه عبارتاند از:
- Zabbix
- PRTG
- SolarWinds NPM
- ManageEngine OpManager
- LogicMonitor
- Grafana
- Prometheus
- Observium
- LibreNMS
- Wireshark برای تحلیل عمیق بستهها
- iperf برای تست Throughput
- Ping و Traceroute برای بررسی مسیر و تأخیر
انتخاب ابزار مناسب به اندازه شبکه، بودجه، مهارت تیم فنی، نوع تجهیزات و سطح مشاهدهپذیری مورد نیاز بستگی دارد. مهمتر از نام ابزار، این است که دادههای درست جمعآوری شوند و تیم شبکه بتواند بر اساس آنها تصمیم عملیاتی بگیرد.
یک رویکرد مرحلهای برای عیبیابی Bottleneck شبکه
برای جلوگیری از تصمیمگیریهای پراکنده، بهتر است فرآیند تشخیص گلوگاه شبکه بهصورت مرحلهای انجام شود:
- شکایت کاربران و زمان دقیق بروز مشکل را ثبت کنید.
- سرویسهای تحت تأثیر را مشخص کنید.
- وضعیت Baseline را با شرایط فعلی مقایسه کنید.
- لایه فیزیکی و خطاهای پورتها را بررسی کنید.
- مصرف CPU، RAM و Interface تجهیزات شبکه را تحلیل کنید.
- با NetFlow یا ابزارهای مشابه، جریان ترافیک را بررسی کنید.
- Latency، Packet Loss و Jitter را در مسیرهای حیاتی بسنجید.
- وضعیت سرورها، Storage و نرمافزارهای وابسته را همزمان بررسی کنید.
- در صورت نیاز، سیاستهای QoS یا ظرفیت لینکها را اصلاح کنید.
- پس از اعمال تغییر، نتیجه را با دادههای قبل مقایسه کنید.
جمعبندی
شناسایی Bottleneck شبکه تنها با مشاهده شکایت کاربران یا بررسی پهنای باند اینترنت امکانپذیر نیست. در زیرساختهای امروزی، گلوگاه میتواند در هر نقطهای از مسیر ارتباطی، از کابل شبکه تا سرورهای ابری، ایجاد شود.
سازمانهایی که از مانیتورینگ مستمر، تحلیل ترافیک، Baseline عملکرد و ابزارهای Observability استفاده میکنند، قادر خواهند بود مشکلات را پیش از تأثیرگذاری گسترده بر کاربران شناسایی و برطرف کنند.
در نهایت، موفقیت در مدیریت عملکرد شبکه به جای اتکا بر حدس و تجربه، وابسته به جمعآوری دادههای دقیق، تحلیل مستمر و دید جامع نسبت به کل زیرساخت فناوری اطلاعات است. این رویکرد نه تنها باعث کاهش Downtime میشود، بلکه بهرهوری کاربران، کیفیت سرویسها و بازگشت سرمایه در زیرساخت شبکه را نیز به شکل محسوسی افزایش میدهد.